Kiến trúc dữ liệu cho AI là gì? Đó là cách tổ chức dòng dữ liệu để AI dùng được an toàn và kịp thời. Trong fintech, theo anh Đào Tuấn Anh, kiến trúc dữ liệu cho AI đi qua 4 lớp: data pipeline, nền tảng dữ liệu thời gian thực, data pipeline có AI hỗ trợ và agentic data infrastructure.
TÓM TẮT Ý CHÍNH
- Trong Fintech, chiến lược data ingestion quyết định trực tiếp chất lượng sản phẩm và mức độ rủi ro, không chỉ là bài toán kỹ thuật.
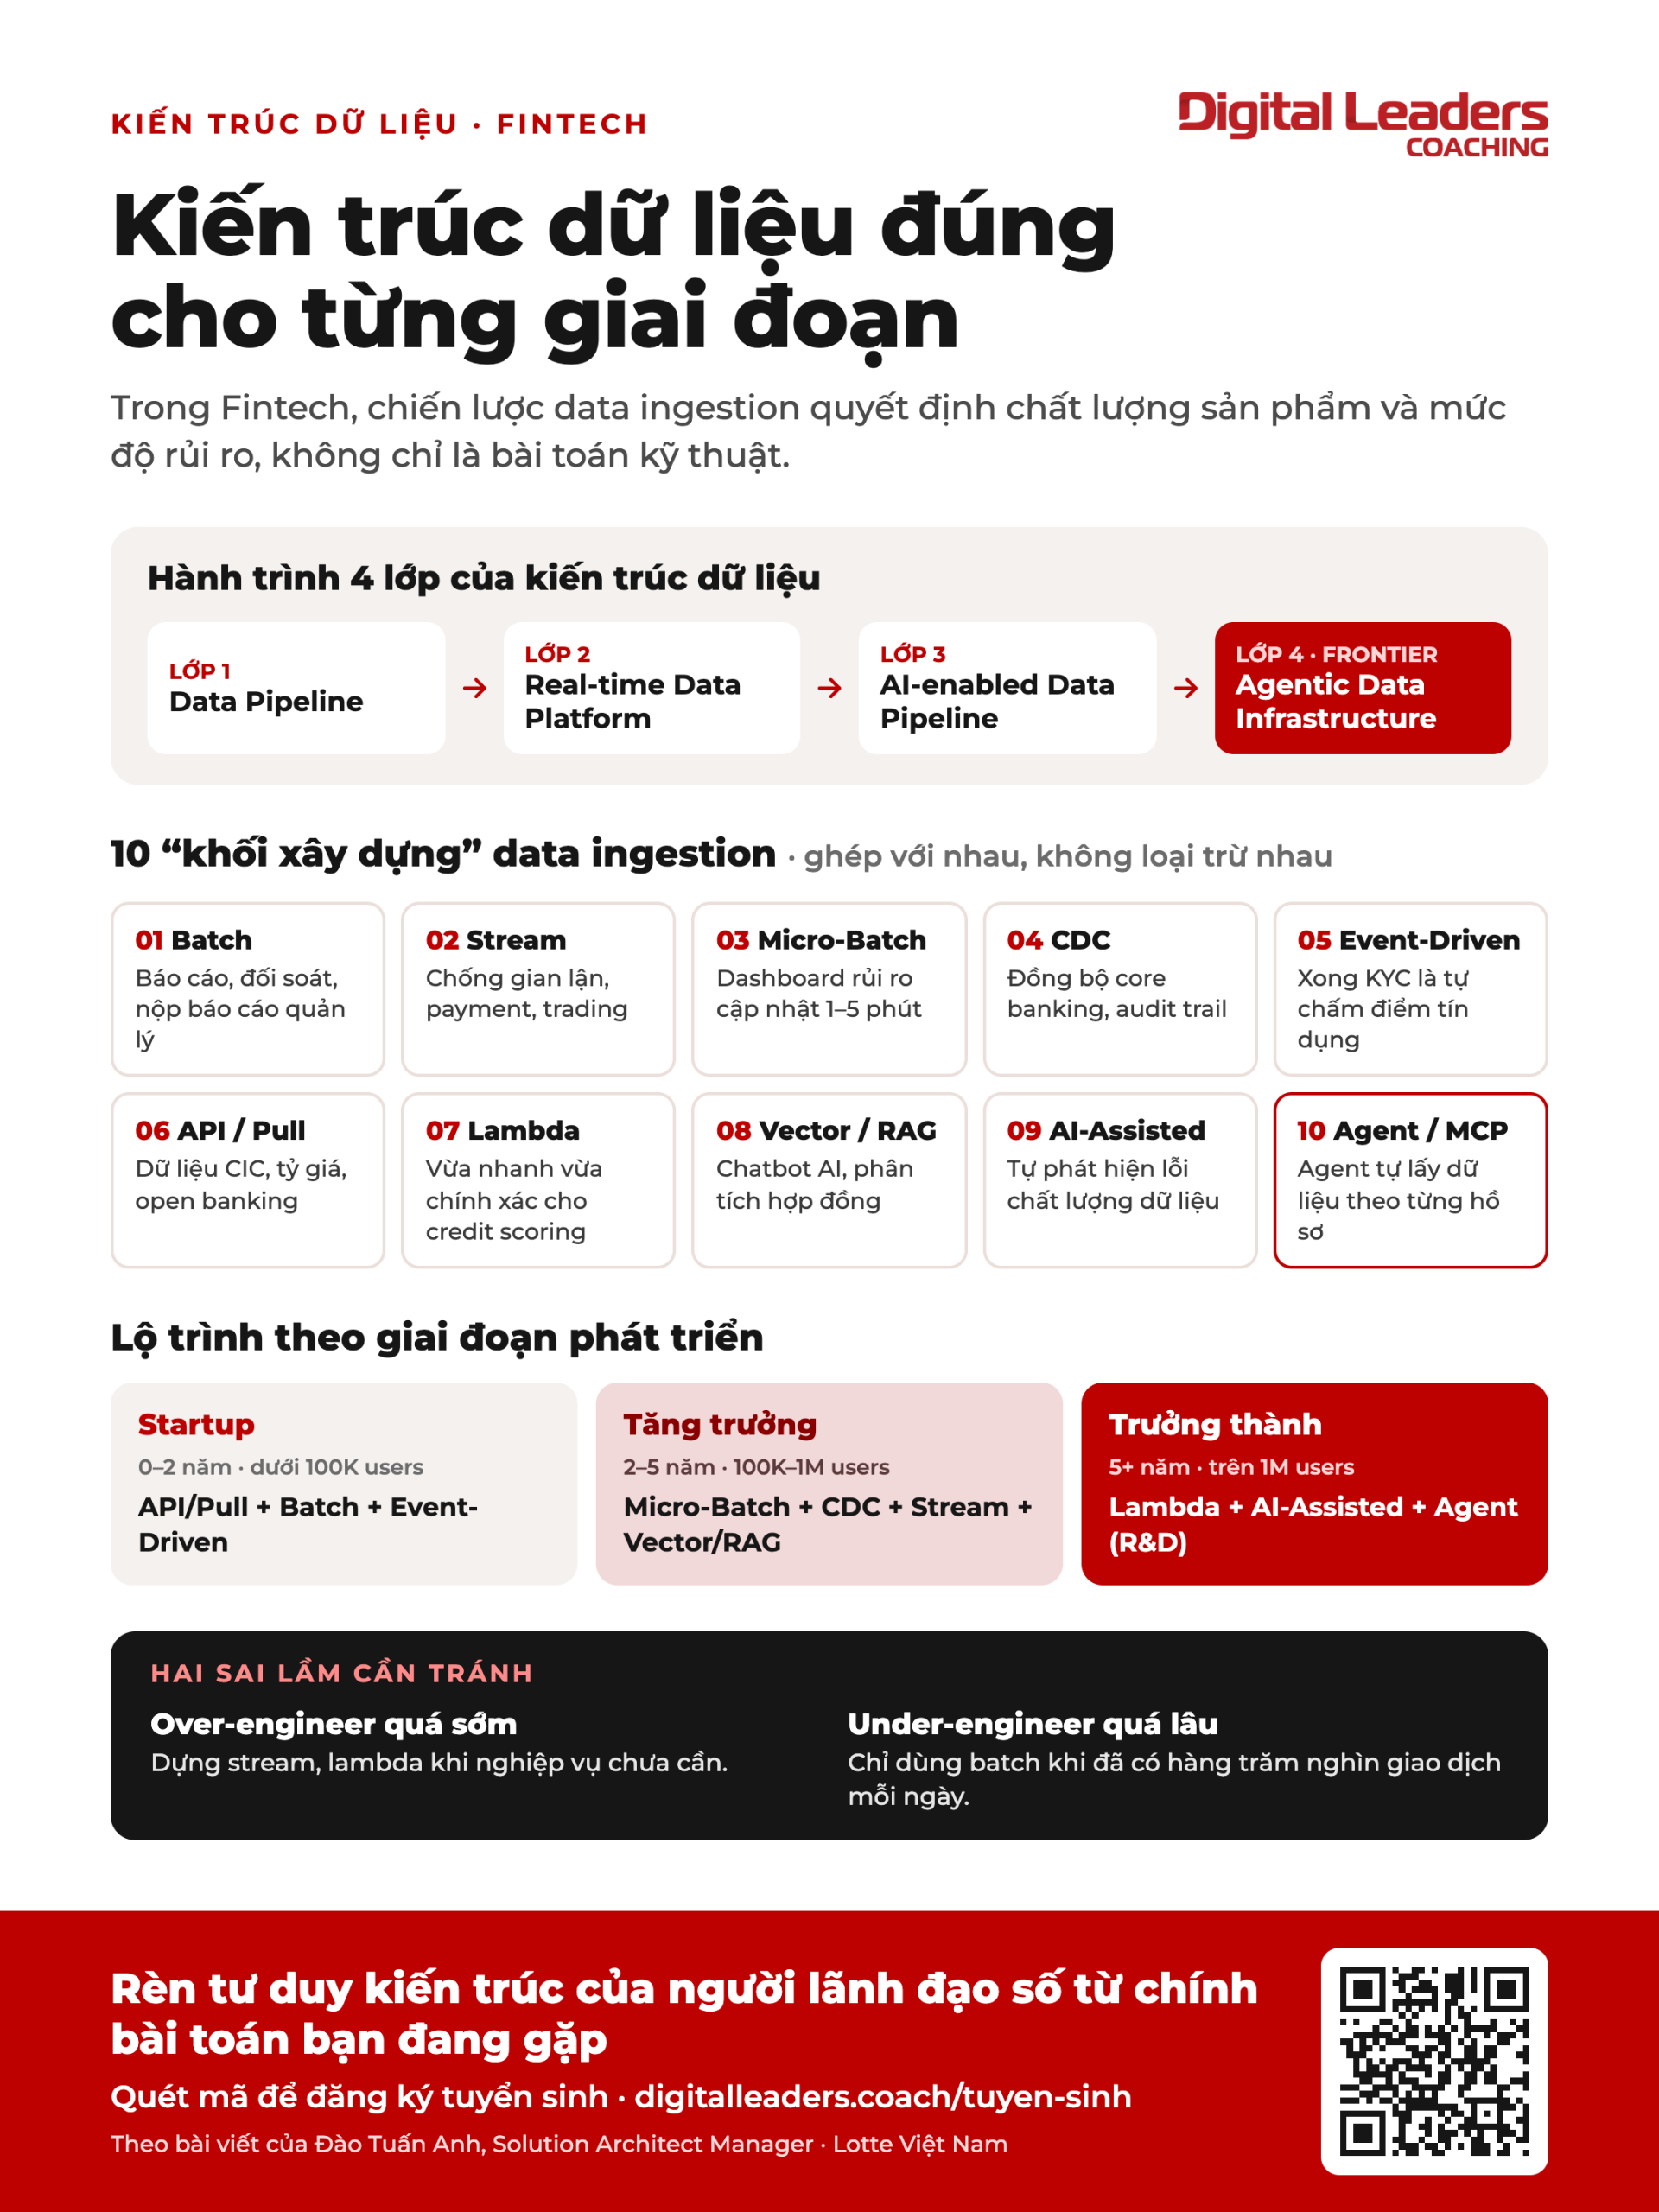
- Kiến trúc dữ liệu đi qua 4 lớp: Data Pipeline → Real-time Data Platform → AI-enabled Data Pipeline → Agentic Data Infrastructure.
- 10 mô hình ingestion là các “khối xây dựng” để kết hợp với nhau, không phải các lựa chọn loại trừ.
- Lộ trình theo giai đoạn: startup ưu tiên Batch, API và Event-Driven; giai đoạn tăng trưởng thêm CDC, Stream và Vector/RAG; doanh nghiệp quy mô lớn mới cần Lambda, AI-Assisted và nghiên cứu Agent.
- Hai sai lầm cần tránh: over-engineer quá sớm và under-engineer quá lâu.
CHƯƠNG TRÌNH HUẤN LUYỆN LÃNH ĐẠO SỐ
Bạn đang dẫn dắt đội ngũ phát triển kinh tế số, công nghệ số và muốn rèn năng lực lãnh đạo số trên chính bài toán thật trong công việc? Đăng ký tham gia chương trình Huấn Luyện Lãnh Đạo Số hoàn toàn phi lợi nhuận, cùng các huấn luyện viên đồng hành và một cộng đồng Lãnh Đạo Số hiện đang là các CxO, CDO, Manager.
GHI CHÚ CỦA BAN BIÊN TẬP
Khi AI bắt đầu tham gia vào các quyết định nghiệp vụ như duyệt tín dụng hay phát hiện gian lận, câu hỏi “dữ liệu chảy thế nào trong doanh nghiệp” không còn là việc riêng của đội kỹ thuật. Mỗi lựa chọn kiến trúc dữ liệu kéo theo chi phí hạ tầng, tốc độ ra sản phẩm và rủi ro tuân thủ, và đó là những thứ CIO, CTO và ban lãnh đạo phải chịu trách nhiệm. Bài viết dưới đây của tác giả Đào Tuấn Anh, thành viên cộng đồng, đưa ra một bản đồ để chọn đúng kiến trúc cho từng giai đoạn phát triển, với ví dụ từ ngành Fintech.
Tổng quan: vì sao fintech là “chiến trường” của data ingestion?
Fintech là ngành mà mỗi mili-giây dữ liệu đều có giá trị tiền bạc — theo nghĩa đen. Giao dịch gian lận xảy ra trong vài giây, tín dụng cần phê duyệt tức thì, thị trường biến động từng tick. Vì vậy, chiến lược ingestion không còn là bài toán kỹ thuật thuần túy — nó trực tiếp quyết định chất lượng sản phẩm và mức độ rủi ro.
Trong giai đoạn đầu, bài toán dữ liệu của Fintech chủ yếu là “đưa dữ liệu từ A đến B” — Batch để tổng hợp báo cáo, API để lấy dữ liệu đối tác, CDC để đồng bộ hệ thống và Stream để phản ứng với giao dịch theo thời gian thực.
Nhưng khi Fintech ngày càng vận hành theo thời gian thực và AI trở thành một thành phần của nghiệp vụ, câu hỏi kiến trúc đã thay đổi: Không chỉ là dữ liệu được đưa đi đâu, mà hệ thống phải biết dữ liệu nào cần được lấy, lấy khi nào, xử lý ở mức nào và phục vụ quyết định nào.
Đó chính là hành trình từ Data Pipeline → Real-time Data Platform → AI-enabled Data Pipeline → Agentic Data Infrastructure. Ở lớp truyền thống, pipeline được thiết kế trước và chạy theo những quy trình xác định;
ở lớp hiện đại, hệ thống phản ứng theo Event, hiểu ngữ nghĩa thông qua Vector/RAG, tự phát hiện và xử lý một phần vấn đề bằng AI; và ở frontier, Agent có thể chủ động điều phối việc thu thập, truy vấn và kết hợp dữ liệu theo từng nghiệp vụ.
Tuy nhiên, với Fintech — nơi accuracy, security, governance và auditability quan trọng không kém tốc độ — tương lai không phải là loại bỏ pipeline truyền thống, mà là xây dựng một kiến trúc nhiều lớp, trong đó Batch đảm bảo tính chính xác, Stream đảm bảo tốc độ, CDC đảm bảo tính liên tục, Event-Driven đảm bảo khả năng phản ứng, AI đảm bảo tính thông minh và Agent đảm bảo tính chủ động.
Các mô hình kiến trúc data ingestion – nền móng của kiến trúc dữ liệu cho AI
10 mô hình dưới đây không phải 10 lựa chọn loại trừ nhau — mà là 10 building blocks để kiến trúc sư Fintech ghép thành một Data & AI Infrastructure phù hợp với từng nghiệp vụ.
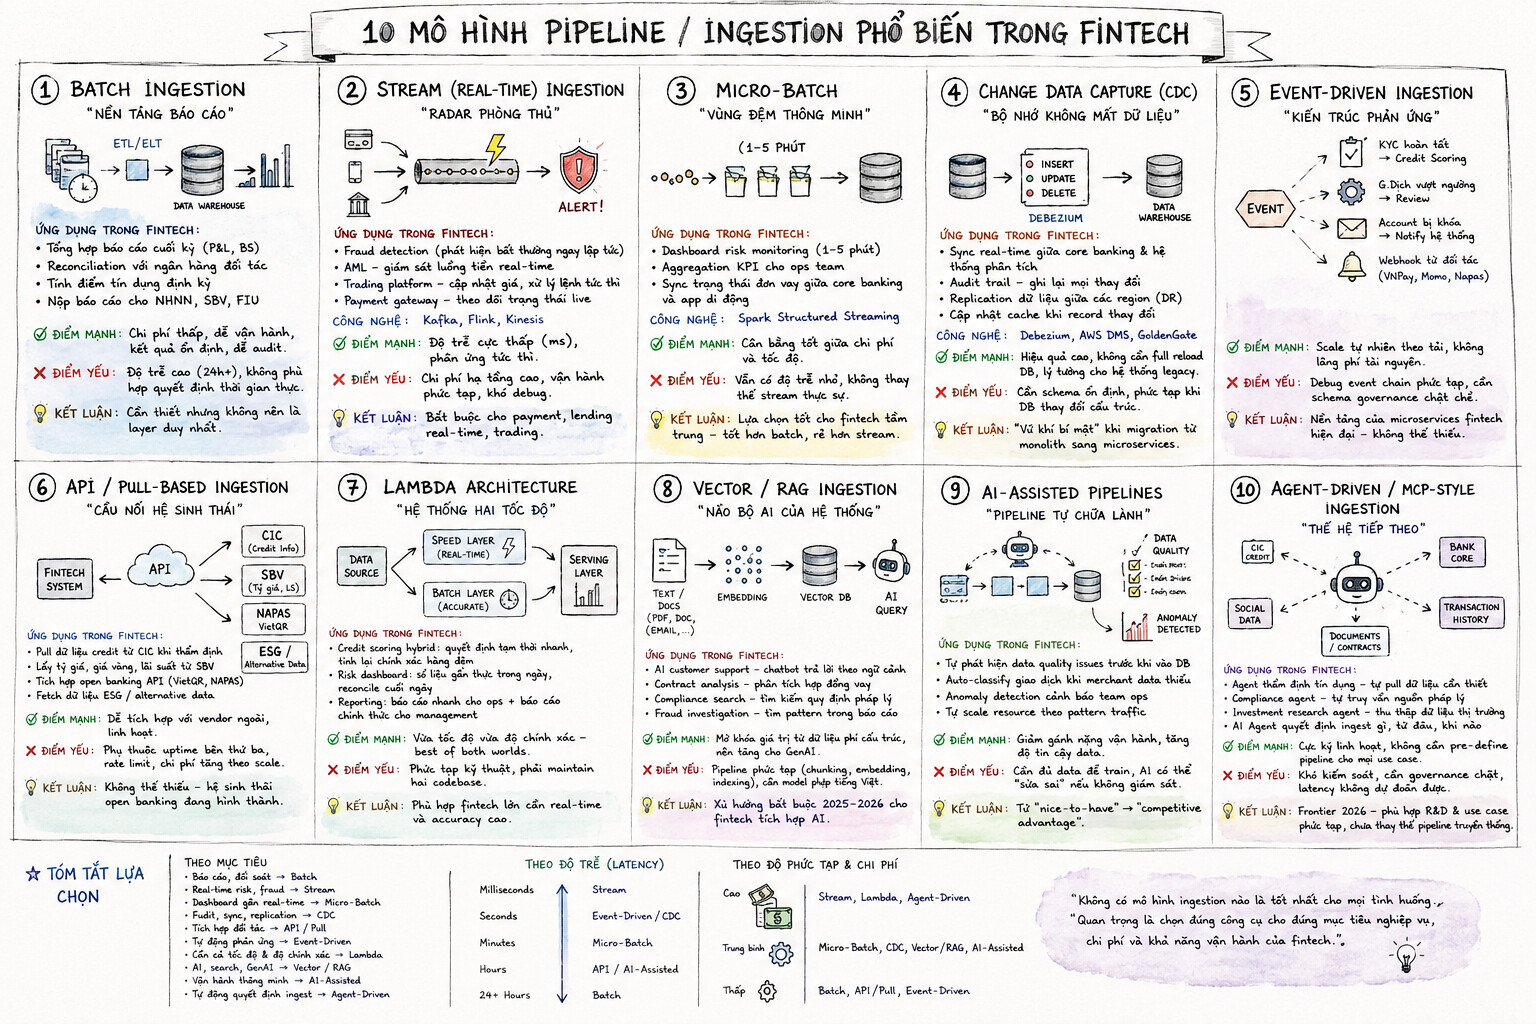
1. Batch Ingestion
Bản chất: Xử lý dữ liệu theo lịch cố định (hàng giờ, hàng ngày, hàng tháng).
Ứng dụng trong Fintech:
- Tổng hợp báo cáo tài chính cuối kỳ (P&L, balance sheet)
- Reconciliation — đối soát giao dịch với ngân hàng đối tác
- Tính toán điểm tín dụng định kỳ (monthly credit score refresh)
- Nộp báo cáo cho cơ quan quản lý (NHNN, SBV, FIU)
Điểm mạnh: Chi phí thấp, dễ vận hành, kết quả ổn định, dễ audit.
Điểm yếu: Độ trễ cao (data lag có thể tới 24h+), không phù hợp với quyết định thời gian thực.
Kết luận: Vẫn cần thiết nhưng không nên là layer duy nhất trong stack của một fintech hiện đại.
2. Stream (Real-Time) Ingestion
Bản chất: Dữ liệu chảy liên tục, xử lý ngay khi phát sinh sự kiện.
Ứng dụng trong Fintech:
- Fraud detection: Phát hiện pattern bất thường ngay khi giao dịch xảy ra — ví dụ: cùng một thẻ quẹt 3 lần trong 30 giây ở 3 địa điểm khác nhau
- AML (Anti-Money Laundering): Giám sát luồng tiền theo thời gian thực
- Trading platform: Cập nhật giá, xử lý lệnh mua/bán tức thì
- Payment gateway: Theo dõi trạng thái giao dịch live
Công nghệ phổ biến: Apache Kafka, Apache Flink, AWS Kinesis
Điểm mạnh: Độ trễ cực thấp (milliseconds), phản ứng ngay với sự kiện nguy hiểm.
Điểm yếu: Chi phí hạ tầng cao, phức tạp trong vận hành và debugging.
Kết luận: Bắt buộc với mọi fintech có tính năng payment, lending real-time, hoặc trading.
3. Micro-Batch
Bản chất: Xử lý dữ liệu theo chunk nhỏ, mỗi vài giây hoặc vài phút.
Ứng dụng trong Fintech:
- Dashboard risk monitoring cập nhật mỗi 1–5 phút (đủ nhanh để phản ứng, không tốn kém như stream)
- Aggregation KPI cho ops team theo dõi trong ngày
- Sync trạng thái đơn vay giữa core banking và app di động
Điểm mạnh: Cân bằng tốt giữa chi phí và tốc độ — đây là lý do Apache Spark Structured Streaming được dùng rộng rãi.
Điểm yếu: Vẫn có độ trễ nhỏ, không thay thế được stream thực sự trong các tình huống nhạy cảm.
Kết luận: Lựa chọn tốt cho fintech tầm trung — tốt hơn batch, rẻ hơn full stream.
4. Change Data Capture (CDC)
Bản chất: Theo dõi và capture chính xác những thay đổi trong database (INSERT / UPDATE / DELETE) theo thời gian thực.
Ứng dụng trong Fintech:
- Sync real-time giữa core banking system và các hệ thống phân tích mà không cần dump toàn bộ DB
- Audit trail — ghi lại mọi thay đổi trạng thái hợp đồng, tài khoản
- Replication dữ liệu giữa các region (DR – Disaster Recovery)
- Cập nhật cache khi record khách hàng thay đổi
Công nghệ phổ biến: Debezium (open-source), AWS DMS, Oracle GoldenGate
Điểm mạnh: Không cần full reload DB, hiệu quả cao, hoàn hảo cho hệ thống legacy cần được hiện đại hóa dần.
Điểm yếu: Cần schema ổn định, phức tạp khi DB có nhiều thay đổi cấu trúc.
Kết luận: Vũ khí bí mật của các fintech đang migration từ monolith sang microservices. Đặc biệt quan trọng khi tích hợp với core banking của ngân hàng đối tác.
5. Event-Driven Ingestion
Bản chất: Pipeline chỉ kích hoạt khi có sự kiện — không chạy theo lịch cố định.
Ứng dụng trong Fintech:
- Khi khách hàng hoàn tất KYC → tự động trigger credit scoring
- Khi giao dịch vượt ngưỡng → kích hoạt quy trình review
- Khi account bị khóa → notify tất cả hệ thống liên quan ngay lập tức
- Webhook từ đối tác thanh toán (VNPay, Momo, Napas)
Điểm mạnh: Scale tự nhiên theo tải, không lãng phí tài nguyên khi không có sự kiện.
Điểm yếu: Debugging event chain phức tạp, cần event schema governance chặt chẽ.
Kết luận: Nền tảng của kiến trúc microservices fintech hiện đại. Không thể thiếu nếu hệ thống có nhiều service giao tiếp với nhau.
6. API / Pull-Based Ingestion
Bản chất: Chủ động gọi API từ hệ thống ngoài để lấy dữ liệu theo lịch hoặc theo nhu cầu.
Ứng dụng trong Fintech:
- Pull dữ liệu credit từ CIC (Credit Information Center) khi thẩm định vay
- Lấy tỷ giá, giá vàng, lãi suất từ SBV/các ngân hàng
- Tích hợp open banking API (VietQR, NAPAS 24/7)
- Fetch dữ liệu ESG/alternative data từ bên thứ ba để scoring
Điểm mạnh: Dễ tích hợp với vendor ngoài, linh hoạt, không cần đầu tư hạ tầng phía đối tác.
Điểm yếu: Phụ thuộc vào uptime của bên thứ ba, rate limit, chi phí API call tăng theo scale.
Kết luận: Không thể thiếu — đặc biệt ở Việt Nam khi hệ sinh thái open banking đang hình thành. Mọi fintech đều cần layer này.
7. Lambda Architecture
Bản chất: Kết hợp song song batch layer (chính xác, chậm) và speed layer (nhanh, gần đúng), merge kết quả ở serving layer.
Ứng dụng trong Fintech:
- Credit scoring hybrid: Speed layer cho quyết định tạm thời trong vài giây, batch layer tính toán lại chính xác hàng đêm
- Risk dashboard: Hiển thị số liệu gần thực trong ngày, reconcile với batch chính xác cuối ngày
- Reporting: Báo cáo nhanh cho ops team + báo cáo chính thức cho management
Điểm mạnh: Đảm bảo vừa có tốc độ vừa có độ chính xác — “best of both worlds”.
Điểm yếu: Phức tạp về mặt kỹ thuật, cần maintain hai codebase xử lý logic tương tự.
Kết luận: Phù hợp với fintech quy mô lớn cần cả real-time lẫn accuracy cao. Các neo-bank lớn (Timo, MoMo ở cấp độ nhất định) có thể cần đến kiến trúc này.
8. Vector / RAG Ingestion
Bản chất: Chuyển dữ liệu phi cấu trúc (văn bản, hợp đồng, email) thành vector embeddings, lưu vào vector DB để AI có thể query ngữ nghĩa.
Ứng dụng trong Fintech:
- AI customer support: Ingest toàn bộ FAQ, chính sách, hợp đồng → chatbot có thể trả lời chính xác theo ngữ cảnh
- Contract analysis: Phân tích hợp đồng vay tự động
- Compliance search: Tìm kiếm theo ngữ nghĩa trong kho quy định pháp lý
- Fraud investigation: AI tìm pattern trong báo cáo sự cố lịch sử
Điểm mạnh: Mở khóa giá trị từ dữ liệu phi cấu trúc vốn bị bỏ qua, nền tảng cho GenAI features.
Điểm yếu: Pipeline phức tạp (chunking, embedding, indexing), cần chọn model embedding phù hợp với tiếng Việt.
Kết luận: Xu hướng bắt buộc 2025–2026 — fintech nào muốn tích hợp AI assistant, smart search, hay GenAI sẽ phải xây layer này.
9. AI-Assisted Pipelines
Bản chất: AI nhúng vào trong pipeline để tự phát hiện anomaly, tự sửa lỗi, tự tối ưu.
Ứng dụng trong Fintech:
- Tự phát hiện data quality issues (missing fields, format lạ, giá trị ngoài ngưỡng) trước khi vào DB
- Auto-classify giao dịch khi merchant data không đầy đủ
- Anomaly detection trong pipeline để cảnh báo team ops trước khi ảnh hưởng tới production
- Tự scale resource theo pattern traffic (cuối tháng, ngày lương…)
Điểm mạnh: Giảm gánh nặng vận hành, tăng độ tin cậy của data.
Điểm yếu: Cần đủ data để train, và AI có thể “sửa sai” theo cách không mong muốn nếu không được giám sát.
Kết luận: Đang chuyển từ “nice-to-have” sang “competitive advantage” — fintech nào triển khai được sẽ có data ops hiệu quả hơn hẳn đối thủ.
10. Agent-Driven / MCP-Style Ingestion
Bản chất: Không có pipeline cố định — AI Agent tự quyết định cần lấy dữ liệu gì, từ đâu, khi nào, và orchestrate việc đó on demand.
Ứng dụng trong Fintech:
- Agent thẩm định tín dụng: tự pull CIC, social data, transaction history, income verification theo từng hồ sơ
- Compliance agent: tự truy vấn các nguồn pháp lý liên quan để kiểm tra một giao dịch cụ thể
- Investment research agent: tự thu thập dữ liệu thị trường, tin tức, báo cáo tài chính theo yêu cầu
- Chính là hướng các AI Agents đang xây dựng — agent tự biết cần lấy dữ liệu gì để phục vụ nghiệp vụ
Điểm mạnh: Cực kỳ linh hoạt, không cần pre-define pipeline cho mọi use case.
Điểm yếu: Khó kiểm soát, cần governance chặt (đặc biệt trong fintech với yêu cầu audit trail cao), latency không thể dự đoán.
Kết luận: Frontier của 2026 — phù hợp với R&D và các use case phức tạp, chưa phù hợp để thay thế hoàn toàn pipeline truyền thống trong môi trường regulated.
Bảng so sánh tổng hợp
| Loại Ingestion | Độ Trễ | Chi Phí | Độ Phức Tạp | Phù Hợp Nhất Với Fintech |
|---|---|---|---|---|
| Batch | Cao (giờ–ngày) | Thấp | Thấp | Reporting, Compliance, Reconciliation |
| Stream | Rất thấp (ms) | Cao | Cao | Fraud, Payment, Trading |
| Micro-Batch | Thấp (giây–phút) | Trung bình | Trung bình | Risk Monitoring, App Sync |
| CDC | Thấp | Trung bình | Trung bình | Core Banking Integration, Audit |
| Event-Driven | Thấp | Trung bình | Cao | Microservices, Workflow Automation |
| API/Pull | Biến động | Thấp–Trung | Thấp | Open Banking, Third-party Data |
| Lambda | Rất thấp + Chính xác | Rất cao | Rất cao | Large-scale Neo-bank, Credit Platform |
| Vector/RAG | N/A | Trung bình | Trung bình–Cao | AI Chatbot, Contract AI, Compliance Search |
| AI-Assisted | N/A | Trung bình | Cao | Data Quality, Auto-ops |
| Agent-Driven | Biến động | Cao | Rất cao | R&D, Complex Workflows, AI-native Apps |
Nên chọn kiến trúc dữ liệu nào theo giai đoạn phát triển?
Fintech startup (0–2 năm, <100K users)
Ưu tiên: API/Pull + Batch + Event-Driven
Xây nền batch vững chắc trước, dùng API/Pull để kết nối hệ sinh thái, event-driven cho workflow nội bộ. Chưa cần đầu tư vào stream hay lambda — over-engineering ở giai đoạn này là cái bẫy phổ biến nhất.
Fintech tăng trưởng (2–5 năm, 100K–1M users)
Ưu tiên: Micro-Batch + CDC + Stream (cho fraud/payment) + Vector/RAG
Đây là giai đoạn cần đầu tư nghiêm túc. Fraud detection không thể chờ batch. CDC là bắt buộc khi scale DB. Vector/RAG nên bắt đầu xây nếu muốn ra mắt AI features trong 12–18 tháng tới.
Fintech trưởng thành / neo-bank (5+ năm, 1M+ users)
Ưu tiên: Lambda Architecture + AI-Assisted Pipelines + Agent-Driven (R&D)
Ở quy mô này, mọi loại ingestion đều cần thiết ở từng ngữ cảnh khác nhau. Đầu tư vào AI-Assisted pipeline để giảm chi phí ops, bắt đầu R&D Agent-Driven cho next-gen products.
Kết luận
Thông điệp cốt lõi của nội dung gốc là đúng nhưng cần được diễn giải đúng hơn trong bối cảnh fintech:
Không phải mọi fintech đều cần stream real-time ngay từ ngày đầu — nhưng mọi fintech đều cần có lộ trình rõ ràng để tiến tới kiến trúc event-driven, observable, và AI-ready.
Sai lầm phổ biến nhất là over-engineer quá sớm (stream khi chưa cần) hoặc under-engineer quá lâu (vẫn chỉ dùng batch khi đã có hàng trăm nghìn giao dịch/ngày). Chiến lược ingestion tốt là chiến lược phù hợp với giai đoạn phát triển và có khả năng nâng cấp khi business scale.
GHI CHÚ CỦA BAN BIÊN TẬP
MCP là gì? Model Context Protocol (MCP) là chuẩn mở do Anthropic công bố và mã nguồn mở vào tháng 11/2024. Chuẩn này quy định cách các ứng dụng AI kết nối với nguồn dữ liệu, công cụ và quy trình bên ngoài. Kiến trúc gồm hai phía: MCP server cung cấp dữ liệu hoặc chức năng qua một giao diện chuẩn, còn MCP client là ứng dụng AI kết nối tới các server đó.
Nhờ vậy, thay vì viết bộ kết nối riêng cho từng cặp “mô hình AI – nguồn dữ liệu”, doanh nghiệp chỉ cần triển khai theo một giao thức chung. Hiện nay, MCP được nhiều trợ lý AI và công cụ lập trình hỗ trợ, và dự án do Linux Foundation bảo trợ. Đây chính là nền tảng kỹ thuật của mô hình “Agent-Driven / MCP-Style Ingestion” trong bài.
Khi để AI Agent tự truy xuất dữ liệu trong môi trường tài chính: tài liệu hướng dẫn tích hợp MCP của OpenAI khuyến nghị chỉ kết nối tới server đáng tin cậy, cấp quyền ở mức tối thiểu, và yêu cầu phê duyệt với các thao tác nhạy cảm. Với doanh nghiệp tài chính, có thể cụ thể hoá thành bốn nguyên tắc:
- Mỗi agent có danh tính và phạm vi quyền riêng.
- Mọi truy vấn của agent được ghi log đủ để audit.
- Dữ liệu nhạy cảm được che trước khi đưa tới mô hình.
- Quyết định có tác động tài chính luôn có bước con người xác nhận.
Đây cũng là lý do tác giả xếp mô hình này ở nhóm “frontier” và chưa khuyến nghị dùng nó thay thế pipeline truyền thống.
GÓC NHÌN LÃNH ĐẠO: 5 CÂU HỎI TRƯỚC KHI ĐẦU TƯ KIẾN TRÚC DỮ LIỆU CHO AI
Từ chia sẻ của anh Đào Tuấn Anh, người dẫn dắt công nghệ có thể tự hỏi 5 câu sau trước khi đầu tư kiến trúc dữ liệu cho AI:
1. Dữ liệu cần “tươi” đến mức nào? Báo cáo cuối ngày chỉ cần batch; chấm điểm gian lận cần dòng dữ liệu thời gian thực.
2. Data pipeline hiện tại có đáng tin cậy chưa? AI chỉ tốt bằng dữ liệu nó nhận được; nền móng yếu thì mô hình nào cũng sai.
3. Đội ngũ đang ở giai đoạn nào? Startup không cần kiến trúc của neo-bank; hãy chọn theo quy mô và năng lực vận hành.
4. Ai kiểm soát dữ liệu khi agent tự truy xuất? Agentic data infrastructure cần quyền truy cập, nhật ký và cơ chế phê duyệt rõ ràng.
5. Giá trị kinh doanh đo bằng gì? Gắn mỗi lớp kiến trúc dữ liệu cho AI với một chỉ số: thời gian phát hiện gian lận, chi phí vận hành, trải nghiệm khách hàng.
Hạ tầng dữ liệu cho AI cần gì?
Hạ tầng dữ liệu cho AI không bắt đầu từ mô hình AI, mà từ data pipeline. Một kiến trúc dữ liệu cho AI vững chắc cần ba điều: dữ liệu được thu nạp đúng lúc, chất lượng được kiểm soát, và quyền truy cập được quản trị chặt chẽ – đặc biệt trong ngành tài chính.
Thu nạp đúng lúc: chọn mô hình ingestion phù hợp – batch, stream, CDC hay event-driven – theo độ trễ mà từng nghiệp vụ chấp nhận được.
Chất lượng kiểm soát được: data pipeline cần kiểm tra lược đồ, phát hiện bất thường và theo dõi nguồn gốc dữ liệu, để mô hình AI không học từ dữ liệu sai.
Quản trị quyền truy cập: khi kiến trúc dữ liệu cho AI tiến tới agentic data infrastructure, các AI agent tự truy xuất dữ liệu qua giao thức như MCP; mọi truy cập cần được cấp quyền, ghi nhật ký và có thể thu hồi.
4 lớp của kiến trúc dữ liệu cho AI trong fintech
Lớp 1 – Data pipeline: thu nạp và xử lý dữ liệu theo lô, phục vụ báo cáo và đối soát. Đây là nền móng của mọi kiến trúc dữ liệu cho AI.
Lớp 2 – Nền tảng dữ liệu thời gian thực: lớp thứ hai của kiến trúc dữ liệu cho AI, dùng stream và CDC giúp phát hiện gian lận, cập nhật số dư và thông báo giao dịch tức thì.
Lớp 3 – AI-enabled data pipeline: nơi kiến trúc dữ liệu cho AI bắt đầu dùng vector/RAG ingestion và pipeline có AI hỗ trợ làm sạch, phân loại, làm giàu dữ liệu.
Lớp 4 – Agentic data infrastructure: AI agent tự tìm, truy vấn và kết hợp dữ liệu từ nhiều nguồn để hoàn thành nhiệm vụ, dưới sự quản trị của con người.
Câu hỏi thường gặp về kiến trúc dữ liệu cho AI
Kiến trúc dữ liệu cho AI khác gì kiến trúc dữ liệu truyền thống?
Kiến trúc truyền thống phục vụ báo cáo và phân tích. Kiến trúc dữ liệu cho AI phải phục vụ thêm mô hình và agent: dữ liệu thời gian thực, dữ liệu phi cấu trúc dạng vector, và cơ chế quản trị khi máy tự truy xuất dữ liệu.
Data pipeline có còn cần thiết khi đã có AI?
Có. Data pipeline vẫn là lớp nền của kiến trúc dữ liệu cho AI. AI chỉ giúp pipeline thông minh hơn, không thay thế việc thu nạp và kiểm soát chất lượng dữ liệu.
Agentic data infrastructure là gì?
Là hạ tầng dữ liệu cho phép AI agent tự khám phá, truy vấn và kết hợp dữ liệu qua các giao thức chuẩn như MCP, thay vì con người viết từng pipeline cố định cho mỗi yêu cầu.
Fintech startup nên bắt đầu kiến trúc dữ liệu cho AI từ đâu?
Từ những mô hình đơn giản, dễ vận hành như batch và API ingestion, rồi bổ sung stream hoặc CDC khi nghiệp vụ thật sự cần dữ liệu thời gian thực – như phần khuyến nghị theo giai đoạn trong bài.
Rủi ro lớn nhất của agentic data infrastructure trong tài chính là gì?
Là mất kiểm soát truy cập dữ liệu nhạy cảm. Vì vậy cần phân quyền theo nguyên tắc tối thiểu, ghi nhật ký mọi truy vấn của agent và có người phê duyệt với các thao tác quan trọng.
Người lãnh đạo công nghệ cần hiểu gì về kiến trúc dữ liệu cho AI?
Không cần thuộc từng công cụ, nhưng cần hiểu mỗi lớp kiến trúc giải quyết bài toán kinh doanh nào, chi phí vận hành ra sao, và đội ngũ đã sẵn sàng cho lớp tiếp theo chưa.
THAM KHẢO & ĐỌC THÊM VỀ KIẾN TRÚC DỮ LIỆU CHO AI
- Introducing the Model Context Protocol (Anthropic): bài công bố MCP.
- What is the Model Context Protocol?: tài liệu chính thức của MCP.
- Apache Kafka và Apache Flink: hai công nghệ stream được nhắc trong mục 2.
- Debezium Documentation: công cụ CDC mã nguồn mở được nhắc trong mục 4.
- EA – Từ mô hình hàn lâm đến tư duy quy hoạch doanh nghiệp
- Enterprise Architecture (EA) – Từ chiến lược đến bản đồ quy hoạch chi tiết
VỀ TÁC GIẢ
Solution Architect Manager · Lotte VietNam
Hạt giống mùa 9 · Hà Nội
Nguồn: Digital Leaders Publishing Club — bài gốc (tác giả: Đào Tuấn Anh — @anhdt2603 trên forum). Bản quyền thuộc tác giả gốc.
 [VỀ CHÚNG TÔI]
– Digital Leaders Coaching là chương trình huấn luyện hoàn toàn phi lợi nhuận, có mục tiêu nâng tầm và tâm những bạn muốn trở thành Lãnh Đạo Số trong tương lai để dẫn dắt chuyển đổi số của doanh nghiệp.
– Đăng ký tuyển sinh ngay: https://digitalleaders.coach/tuyen-sinh/